単一ノードのボトルネック:垂直スケーリング(スケールアップ)が限界を迎えるとき
昨年、私たちのチームはプライマリのPostgreSQLインスタンスが継続的な書き込みトラフィックに耐えきれず、悲鳴を上げるのを目の当たりにしました。イベント追跡テーブルは8億2,000万行を超え、ディスクI/O使用率は常に95%前後で推移し、メモリ圧迫によりバッファキャッシュヒット率は80%を下回る事態に陥っていました。
私たちはまず、定石ともいえる緊急対応策に取り掛かりました。AWS RDSのインスタンスタイプをdb.r6g.4xlarge(16 vCPU、128 GB RAM)からdb.r6g.16xlarge(64 vCPU、512 GB RAM)へと大幅に増強し、WALバッファも64 MBまで引き上げました。しかし、垂直スケーリングは問題を先送りにしているに過ぎません。ハードウェアのアップグレードによる投資対効果は急速に逓減していきます。物理CPUソケットの飽和、月額数百万円規模のクラウド請求、そして数テラバイト規模のテーブルに対して6〜8時間もメンテナンスロックを保持し続けるautovacuumサイクルという現実に直面することになるのです。
当初はアプリケーション層で独自にシャーディングを実装することも検討しました。しかし、複数のマイクロサービス間にコネクションプールを分散させ、2相コミット(2PC)をアプリケーションコード内で自作することは、将来的な保守の悪夢を招くだけです。私たちが求めていたのは、複雑なJOIN、複合インデックス、トランザクション、外部キーといったネイティブPostgreSQLの機能をそのまま維持しながら、汎用ハードウェアに書き込みとクエリを水平分散できるアーキテクチャでした。
基本概念:CitusがPostgreSQLを透過的にシャーディングする仕組み
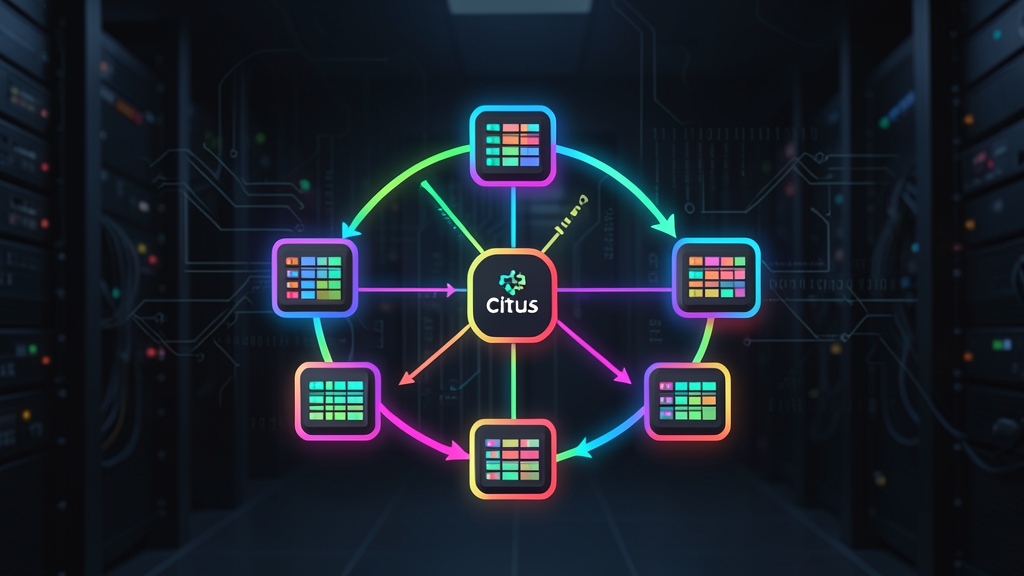
Citusは、標準的なPostgreSQLを分散データベースエンジンへと変貌させるオープンソースの拡張機能です。開発者が手動でルーティングロジックを実装する必要はなく、Citusが複数の独立したPostgreSQLインスタンスを協調するクラスタとしてまとめ上げます。
クラスタアーキテクチャ:コーディネーターノードとワーカーノード
Citusクラスタは、役割を2つに明確に分離しています。
- コーディネーターノード(Coordinator Node): クライアントからの唯一のゲートウェイとして機能します。システムカタログ内にクラスタのメタデータを保持し、クエリのパース、分散実行計画の作成、ワーカーノードへのサブクエリの委託、そして返却された結果の集約を行います。アプリケーションは、標準的なPostgreSQLドライバ(
pgx、psycopg2、JDBCなど)を使用して、特別なプロトコルの変更なしにこのノードへ直接接続できます。 - ワーカーノード(Worker Nodes): 物理的なシャードを保持し、クエリを並列処理します。各ワーカーノードはCitusをロードしたネイティブのPostgreSQLインスタンスを実行しており、独立したCPUコア、RAM、NVMeディスクを活用してサブクエリを並行実行します。
Citusにおけるテーブルトポロジー
Citus内のテーブルは、大きく3つのカテゴリに分類されます。
- 分散テーブル(Distributed Tables): 分散カラム(シャードキー)に基づいて複数のシャードへと分割されるテーブルです。Citusは、コンシステントハッシュ法を用いて、通常32個または64個の論理パーティションを各ワーカーに分散配置します。
- 参照テーブル(Reference Tables): すべてのワーカーノードに完全なコピーが複製されるテーブルです。分散イベントテーブルと頻繁にJOINされる、データ件数の少ないルックアップ用テーブル(プラン一覧、国コード、権限ロールなど、5万行未満のもの)に最適です。
- ローカルテーブル(Local Tables): コーディネーターノード上にのみ存在する通常のPostgreSQLテーブルです。管理者用スキーマ、メタデータ、移行監査ログテーブルなどに適しています。
ハンズオン:マルチノードクラスタの構築とデータのシャーディング
Docker環境で3ノード構成のCitusクラスタを実際に構築し、イベントストリームテーブルをパーティショニングして、クエリル―ティングがどのように動作するかを確認してみましょう。
ステップ1: Docker Composeによるクラスタの起動
公式のCitus Dockerイメージを使用し、共通のブリッジネットワーク上にコーディネーター1台とワーカー2台を立ち上げます。
# プロジェクトディレクトリと Compose マニフェストを作成
mkdir citus-cluster && cd citus-cluster
cat << 'EOF' > docker-compose.yml
services:
  coordinator:
    image: citusdata/citus:12.1
    container_name: citus_coordinator
    environment:
      POSTGRES_USER: postgres
      POSTGRES_PASSWORD: secretpassword
      POSTGRES_DB: analytics
    ports:
      - "5432:5432"

  worker1:
    image: citusdata/citus:12.1
    container_name: citus_worker_1
    environment:
      POSTGRES_USER: postgres
      POSTGRES_PASSWORD: secretpassword
      POSTGRES_DB: analytics

  worker2:
    image: citusdata/citus:12.1
    container_name: citus_worker_2
    environment:
      POSTGRES_USER: postgres
      POSTGRES_PASSWORD: secretpassword
      POSTGRES_DB: analytics
EOF

docker compose up -d
ステップ2: コーディネーターへのワーカーノード登録
次に、psqlでコーディネーターのコンテナに接続し、2台のワーカーインスタンスを紐付けます。
docker exec -it citus_coordinator psql -U postgres -d analytics
-- Citus 拡張機能がロードされているか確認
CREATE EXTENSION IF NOT EXISTS citus;

-- コンテナの DNS 名を使用してワーカーノードを登録
SELECT citus_add_node('worker1', 5432);
SELECT citus_add_node('worker2', 5432);

-- ノードのヘルスチェックとクラスタステータスを確認
SELECT nodename, nodeport, isactive, nodecluster FROM pg_dist_node;
ステップ3: スキーマ定義とテーブルの分散配置
分散カラムの選定は、アーキテクチャ設計において最も重要な判断となります。マルチテナントシステムでは、tenant_idやcompany_idを選択することで、テナント固有のクエリの95%を単一のシャード内に閉じ込め、コストの高いノード間ネットワーク通信を回避できます。
-- アカウントプラン用の参照テーブルを作成
CREATE TABLE account_tiers (
    tier_id INT PRIMARY KEY,
    tier_name VARCHAR(50) NOT NULL,
    rate_limit INT NOT NULL
);

-- すべてのワーカーノードに参照テーブルを複製
SELECT create_reference_table('account_tiers');

-- 参照プランのデータを投入
INSERT INTO account_tiers VALUES
(1, 'Free', 1000),
(2, 'Pro', 10000),
(3, 'Enterprise', 100000);

-- パーティショニングされたイベントテーブルを作成
CREATE TABLE tenant_events (
    event_id BIGSERIAL,
    tenant_id INT NOT NULL,
    event_type VARCHAR(100) NOT NULL,
    payload JSONB DEFAULT '{}'::jsonb,
    created_at TIMESTAMPTZ DEFAULT NOW(),
    PRIMARY KEY (tenant_id, event_id)
);

-- tenant_id をハッシュキーとして tenant_events をワーカー間にシャーディング
SELECT create_distributed_table('tenant_events', 'tenant_id');
ここで、tenant_eventsのプライマリキー定義に注目してください。tenant_idとevent_idの複合キーとなっています。これはCitusが意図して要求している仕様です。各ワーカーは自身に割り当てられたシャード内でローカルに制約を検証するため、複合キーを用いることで、書き込みのたびにクロスノードの合意チェック(コンセンサス)を行うことなく一意性を保証できます。
ステップ4: テストデータのロードとシード
テスト目的で生のCSVファイルをJSONペイロードに変換する場合、toolcraft.app/ja/tools/data/csv-to-json のような軽量なブラウザ完結型ユーティリティを使うと、機密データを外部サーバーに送信せずに済みます。ターゲットスキーマが整ったら、コーディネーター経由で擬似テストレコードを一括挿入します。
-- 50 テナントに分散する 500,000 件のテスト用レコードを生成
INSERT INTO tenant_events (tenant_id, event_type, payload, created_at)
SELECT
    (g % 50) + 1 AS tenant_id,
    CASE (g % 3)
        WHEN 0 THEN 'page_view'
        WHEN 1 THEN 'item_purchased'
        ELSE 'session_start'
    END AS event_type,
    json_build_object('metric_val', (random() * 100)::int, 'source', 'web')::jsonb,
    NOW() - (random() * interval '30 days')
FROM generate_series(1, 500000) AS g;
ステップ5: シャードの配置状況とルーティングの確認
投入した50万行のデータが、worker1とworker2上の物理テーブルにどのように分散されたかを検証してみましょう。
-- 生成されたシャードと配置先ノードを確認
SELECT
    logicalrelid::regclass AS table_name,
    shardid,
    nodename,
    nodeport
FROM pg_dist_placement
JOIN pg_dist_node USING (groupid)
ORDER BY shardid
LIMIT 10;
Citusはデフォルトで32個の論理シャードを作成し、それらを利用可能なワーカーに均等に割り当てます(今回の2ノードクラスタではワーカーあたり16シャード)。これにより、各ノードが独立したテーブルパーティションとインデックス構造を持つようになります。
ステップ6: 分散クエリの実行と最適化
内部的に、Citusは「単一シャードへのルーティング」と「分散MapReduce型の並列実行」という2つのパスでクエリプランを生成します。
-- モード 1: 特定シャードへのポイントクエリ(単一シャードルーティング)
EXPLAIN ANALYZE
SELECT count(*)
FROM tenant_events
WHERE tenant_id = 12;
実行計画の出力でCustom Scan (Citus Adaptive)を確認してください。tenant_id = 12は特定のハッシュバケットにマッピングされるため、コーディネーターは該当するデータを保持するワーカーへ直接クエリをルーティングします。ノード間の通信が一切発生しないため、応答時間は通常3ミリ秒未満に収まります。
-- モード 2: 参照テーブルと結合した複数シャード集約
EXPLAIN ANALYZE
SELECT
    t.tier_name,
    e.event_type,
    count(*)
FROM tenant_events e
JOIN account_tiers t ON ((e.tenant_id % 3) + 1) = t.tier_id
WHERE e.created_at >= NOW() - interval '7 days'
GROUP BY t.tier_name, e.event_type
ORDER BY count(*) DESC;
このクエリでは、コーディネーターがすべてのワーカーに対して並列でサブクエリを発行します。account_tiersの完全なコピーが各ノードに存在するため、各ワーカーはローカルシャードと結合処理を完結させ、コンパクトに集約された部分集計結果のみをコーディネーターへ返送して最終集計を行います。
本番環境でCitusを運用するための重要ポイント
CitusによるPostgreSQLのスケーリングは、psql、標準的なマイグレーション、各種インデックスタイプといった使い慣れたエコシステムを維持したまま、単一ノードのハードウェアの壁を突破できる強力な手法です。ステージング環境や本番環境へ導入する前に、以下の3つの原則を常に念頭に置いてください。
第1に、パフォーマンスが要求されるJOINの結合キーと共通の分散キーを選択することです。関連データを同一ノードにコロケーション(共存)させることで、ネットワーク越しの大規模なデータシャッフルを防ぐことができます。第2に、カーディナリティの低いディメンションテーブルには参照テーブルを積極的に活用すること。そして第3に、コードレビューの標準手順としてEXPLAIN ANALYZEを取り入れ、非効率な分散サブプランが本番トラフィックに投入される前に確実に検知することです。