バックアップが機能しなかった夜
私の知人がフィンテックのスタートアップで働いていた。彼らはcronを使ってPostgreSQLデータベースを毎晩バックアップしていた — pg_dump、gzip、S3へのアップロード。シンプルで、クリーンで、自動化されていた。しかし、プライマリサーバーがクラッシュする日まで。
リストアしようとした。バックアップファイルはそこにあった。リストアコマンドを実行した。失敗した。サイレントな破損だった — 3週間前のディスクI/Oエラーが書き込みの途中でひっそりとファイルを破壊していたが、実際にリストアを試みた人が誰もいなかったため、誰も気づかなかった。
それはバックアップではない。バックアップの格好をした偽りの安心感だ。
なぜこれが思っている以上に起きるのか
ほとんどのチームはバックアップを設定したら、二度と触れない。バックアップスクリプトが実行され、ファイルがどこかに保存され、監視ダッシュボードがグリーンを示し、みんな安心して眠る。しかし、表面下にはいくつかの障害モードが潜んでいる:
- サイレントな破損:ディスクエラー、ネットワークの切断、またはファイルシステムの問題により、cronログにエラーが出ることなくバックアップファイルが破損する可能性がある。
- 部分的な書き込み:バックアッププロセスがダンプの途中でkillされた場合(OOMkiller、タイムアウト、サーバー再起動)、一見完全に見える切り詰められたファイルが残る。
- リストア時のスキーマの不一致:バックアップは正常にリストアされる — しかし、テーブルやカラムがターゲット環境と一致しないためにアプリが失敗する。
- 認証情報と権限のずれ:リストアは技術的には成功するが、リストアされたデータベースユーザーが新しい環境で適切な権限を持っていない。
- データベースバージョンの非互換性:PostgreSQL 14のpg_dumpはPostgreSQL 12に特定のケースでクリーンにリストアされない。
根本原因は常に同じだ:バックアップは誰も読まない書き込み操作だ。実際に必要になったときに初めて壊れていたことがわかる。
3つのアプローチ — そして2つが不十分な理由
アプローチ1:定期的な手動テスト
四半期ごとの「リストア訓練」を実施するチームもある — バックアップを選び、テスト環境を立ち上げ、リストアを試みる。何もしないよりはましだが、手動なので忙しいときにはスキップされる。四半期ごとということは、最大90日間の未検出の破損を意味する。また、先週火曜日の午前3時にサイレントに失敗したバックアップも検出できない。
アプローチ2:チェックサム検証のみ
一歩進める:作成直後にバックアップファイルのMD5またはSHA256ハッシュを生成し、リストア前にハッシュを検証する。転送中または保存中の破損を検出できる。良い方法だ — しかし、バックアップが論理的に有効かどうかはわからない。半分しか書き込まれていないpg_dumpの完全で破損していないgzipは、チェックサムチェックをパスしてもリストアに失敗する。
アプローチ3:自動リストア&検証パイプライン
これが実際に機能するアプローチだ。すべてのバックアップが自動的に使い捨て環境にリストアされ、リストアされたデータに対してキーとなる整合性チェックが実行され、何か失敗した場合のみアラートが届く。それ以外は静かなグリーン。その構築方法を解説する。
パイプラインの構築:ステップごとに
ステップ1 — メタデータサイドカー付きの構造化バックアップ
バックアップスクリプトがダンプと並行してJSONメタデータファイルを出力するようにする。これが、後で検証ジョブが読み込むコントラクトになる:
#!/bin/bash
BACKUP_DIR="/backups/postgres"
TIMESTAMP=$(date +%Y%m%d_%H%M%S)
BACKUP_FILE="$BACKUP_DIR/db_$TIMESTAMP.dump"
META_FILE="$BACKUP_DIR/db_$TIMESTAMP.meta.json"

pg_dump -Fc -h localhost -U postgres mydb > "$BACKUP_FILE"
EXIT_CODE=$?

SHA256=$(sha256sum "$BACKUP_FILE" | awk '{print $1}')
SIZE=$(stat -c%s "$BACKUP_FILE")

cat > "$META_FILE" <<EOF
{
  "timestamp": "$TIMESTAMP",
  "exit_code": $EXIT_CODE,
  "file": "$BACKUP_FILE",
  "sha256": "$SHA256",
  "size_bytes": $SIZE,
  "pg_version": "$(pg_dump --version | grep -oP '\d+\.\d+')",
  "verified": false
}
EOFverifiedフラグはfalseとして始まり、リストアとチェックのサイクルが成功した後にのみ反転される。falseのままであれば、何か問題が発生したことがわかる。
ステップ2 — 使い捨てDockerコンテナでの隔離リストア
リストアは隔離された環境で行うべきだ — その後に破棄される新しいコンテナで、状態を残さない:
#!/bin/bash
# restore_and_verify.sh
BACKUP_FILE="$1"
CONTAINER="pg-verify-$(date +%s)"

docker run -d \
  --name "$CONTAINER" \
  -e POSTGRES_PASSWORD=verifypass \
  -e POSTGRES_DB=verify_db \
  postgres:16 > /dev/null

sleep 5  # postgresの起動を待機

# バックアップをリストア
docker exec -i "$CONTAINER" \
  pg_restore -U postgres -d verify_db < "$BACKUP_FILE"
RESTORE_EXIT=$?

if [ $RESTORE_EXIT -ne 0 ]; then
  echo "リストア失敗: $BACKUP_FILE"
  docker rm -f "$CONTAINER"
  /opt/scripts/send_alert.sh "$BACKUP_FILE のリストアに失敗"
  exit 1
fi

# 整合性チェッカーに処理を引き渡す
python3 /opt/scripts/verify_integrity.py "$CONTAINER" "$BACKUP_FILE"
VERIFY_EXIT=$?

docker rm -f "$CONTAINER"
exit $VERIFY_EXIT
ステップ3 — リストアされたデータに対するSQL整合性チェック
リストア成功だけでは不十分だ。実際のクエリを実行してデータがアプリケーションにとって意味をなすか検証する。スキーマに合わせてカスタマイズする — 目標は論理的な破損を検出することであり、単なる技術的な失敗の検出ではない:
import subprocess
import json
import sys

def run_check(container, query, description):
    result = subprocess.run(
        ["docker", "exec", container,
         "psql", "-U", "postgres", "-d", "verify_db",
         "-t", "-c", query],
        capture_output=True, text=True
    )
    value = result.stdout.strip()
    print(f"[チェック] {description}: {value}")
    return value

container = sys.argv[1]
backup_file = sys.argv[2]
meta_file = backup_file.replace(".dump", ".meta.json")

checks = [
    ("SELECT COUNT(*) FROM users", "usersテーブルの行数"),
    ("SELECT COUNT(*) FROM orders WHERE created_at > NOW() - INTERVAL '30 days'", "最近の注文数"),
    ("SELECT MAX(updated_at) FROM products", "製品の最終更新日時"),
]

failed = 0
for query, desc in checks:
    result = run_check(container, query, desc)
    if result in ("", "0", None):
        print(f"[警告] 疑わしい結果: {desc}")
        failed += 1

with open(meta_file, "r+") as f:
    meta = json.load(f)
    meta["verified"] = (failed == 0)
    meta["check_failures"] = failed
    f.seek(0)
    json.dump(meta, f, indent=2)
    f.truncate()

if failed > 0:
    subprocess.run(["/opt/scripts/send_alert.sh",
                    f"{backup_file} で {failed} 件の整合性チェックが失敗"])

sys.exit(0 if failed == 0 else 1)usersテーブルの行数がゼロはレッドフラグだ。毎日変更されていることがわかっているテーブルで3年前の「最終更新製品」タイムスタンプも同様だ。チェックはデータベースにとっての正常がどのように見えるかを反映すべきだ。
ステップ4 — cronで全体を繋げる
# /etc/cron.d/backup-verify
# 午前2時にバックアップ、午前3時に検証
0 2 * * * postgres /opt/scripts/backup.sh >> /var/log/backup.log 2>&1
0 3 * * * postgres /opt/scripts/restore_and_verify.sh \
  $(ls -t /backups/postgres/*.dump | head -1) >> /var/log/verify.log 2>&1
ステップ5 — 失敗時にアラート、成功時はサイレント
パイプラインは正常動作時には見えないべきだ。シンプルなSlackウェブフックがインフラの複雑さを加えることなくアラートを処理する:
#!/bin/bash
# send_alert.sh
MESSAGE="$1"
WEBHOOK_URL="https://hooks.slack.com/services/YOUR/WEBHOOK"

curl -s -X POST -H 'Content-type: application/json' \
  --data "{\"text\": \":rotating_light: DBバックアップ検証失敗: $MESSAGE\"}" \
  "$WEBHOOK_URL"
データフォーマット変換に関する実践的なメモ
リストア検証中に出てくることの一つ:エクスポートされたテーブルデータを異なるフォーマットで検査またはクロスチェックする必要がある場合がある — たとえば、マイグレーション前後でCSVエクスポートとリストアされた行数を比較するなど。
このようにデータのインポートやスポットチェックのためにCSVをJSONに素早く変換する必要があるとき、私はtoolcraft.app/ja/tools/data/csv-to-jsonを使用している — ブラウザ上で完全に動作するため、データがマシンから出ることはない。機密性の高いデータベースエクスポートを扱っていて、見知らぬオンラインサービスを通じてパイプしたくない場合、これは重要だ。
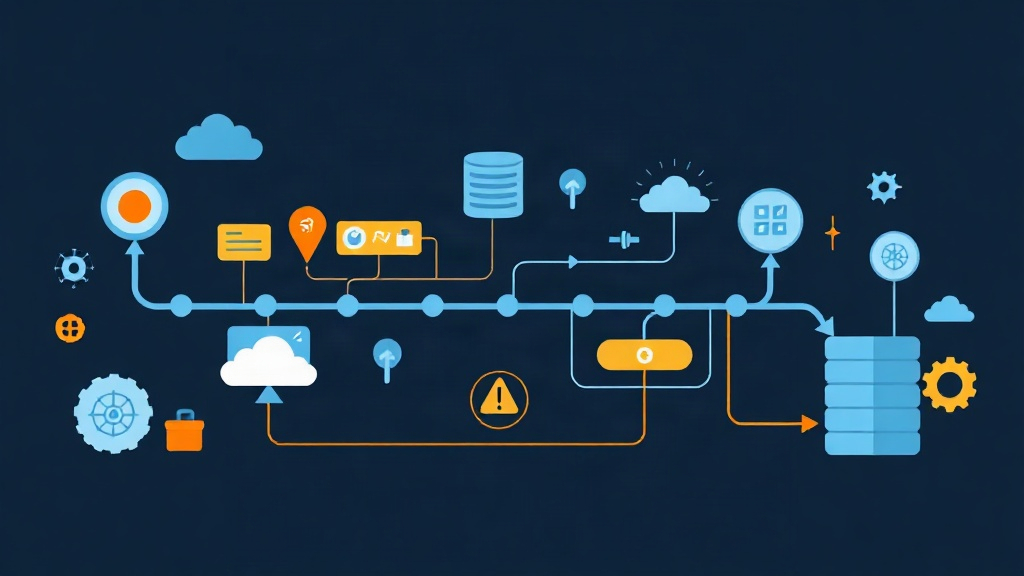
完全なパイプラインの全体像
- 午前2:00 — pg_dumpが実行される;SHA256、サイズ、終了コードを含むメタデータサイドカーが作成される
- 午前3:00 — リストアスクリプトが最新の.dumpを取得し、Dockerコンテナを起動してリストアする
- 午前3:10 — Pythonの整合性チェッカーがSQLクエリを実行し、メタデータの
verified: true/falseを更新する - 午前3:11 — 何か失敗した場合はSlackアラートが発火する;それ以外は完全な沈黙
- 午前3:12 — Dockerコンテナが破棄され、ディスクスペースが解放される
5GBのデータベースでサイクル全体は15分未満だ。メタデータファイルが監査証跡として蓄積される — 任意の日に振り返って、最後に検証されたバックアップはどれか、そしていつ検証されたかを正確に確認できる。
基本構成が動いたら追加すべきチェック
- 行数デルタアラート:今日のリストアされた行数と昨日の行数を比較する。usersテーブルの行数が一晩で90%減少するのは、ほぼ間違いなく想定外だ。
- リストア時間のベンチマーク:リストアにかかる時間を追跡する。突然の3倍のスパイクは、バックアップが予想外に大きくなっているか、Dockerホストがリソース不足であることを示す可能性がある。
- アプリケーションレベルのスモークテスト:リストア後、アプリのヘルスチェックエンドポイントをリストアされたデータベースに向ける。リストアは成功してもアプリが起動時に失敗するデータベースは、やはり復旧失敗だ。
- オフサイト検証:S3にバックアップをアップロードしている場合、S3からダウンロードして再検証する別のジョブを実行する。そうしなければ決して気づかないサイレントなアップロード失敗を検出できる。
本当に重要なマインドシフト
ここでの本当の変化は技術的なものではない — すべてのバックアップを証明されるまで未検証として扱うことだ。リストアされていないバックアップは仮説であり、安全網ではない。
このパイプラインが動き始めると、チームがバックアップについて話す方法が変わる。「バックアップはある」と言う代わりに、「最後に検証されたバックアップは18時間前だ」と言い始める。それは根本的に異なる会話だ — そして午前2時に何か壊れたときに実際に重要な精度だ。