Bối cảnh & Lý do
Hầu hết các hệ thống homelab đều bắt đầu một cách rất đơn giản. Bạn dựng Pi-hole để lọc DNS, thêm Home Assistant, rồi triển khai media server với Jellyfin hoặc Plex. Mọi thứ vận hành êm đẹp cho đến một ngày, một container mất kiểm soát xả tới 40 GB log vào /var/lib/docker chỉ sau một đêm, khiến ổ cứng khởi động đầy 100%. Hoặc một tác vụ transcode video 4K ngoài dự kiến vắt kiệt mọi nhân CPU trên chiếc mini PC Intel N100, làm đơ hoàn toàn hypervisor. Khi sự cố xảy ra, người nhà thường là người báo mất mạng trước cả khi bạn kịp nhận ra có lỗi.
Việc khắc phục sự cố theo kiểu bị động rất nhanh gây mệt mỏi. Bạn cần một hệ thống giám sát tự động để kịp thời cảnh báo trước khi các dịch vụ sập hoàn toàn.
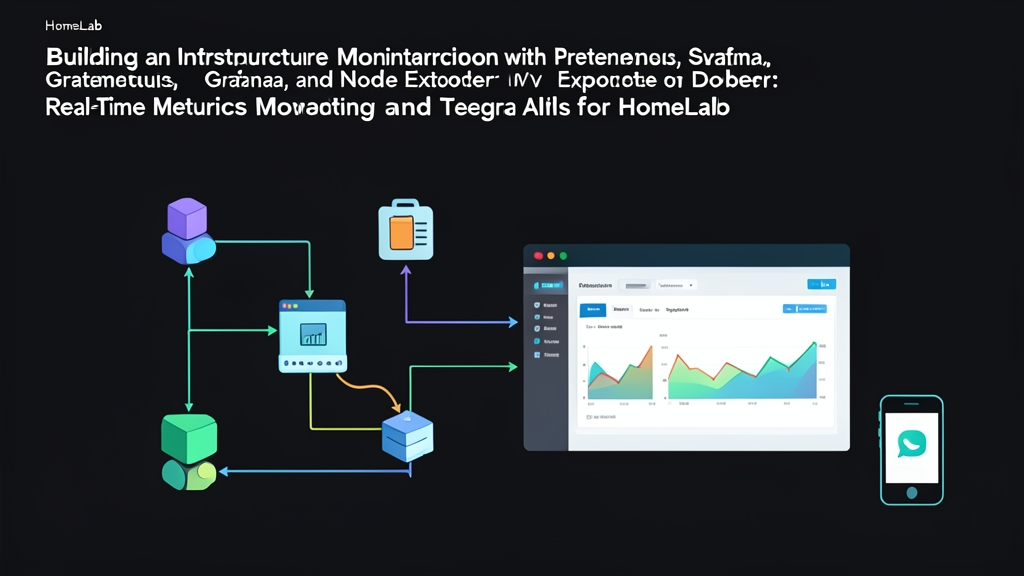
Các công cụ dạng single-binary gọn nhẹ như Netdata rất tiện để kiểm tra nhanh, nhưng bộ ba Prometheus, Node Exporter và Grafana vẫn luôn là tiêu chuẩn vàng. Prometheus hoạt động theo mô hình pull để thu thập (scrape) metrics qua HTTP theo chu kỳ định sẵn (thường là mỗi 15 giây) và lưu trữ vào cơ sở dữ liệu chuỗi thời gian (TSDB) tối ưu cao, chỉ tốn trung bình từ 1.5 đến 2 byte cho mỗi mẫu dữ liệu.
Node Exporter chạy như một agent trực tiếp trên hệ điều hành host, cung cấp các thông số phần cứng thô: thời gian chờ CPU, áp lực bộ nhớ, I/O ổ đĩa NVMe và cảm biến nhiệt độ. Grafana sau đó kết nối với Prometheus để trực quan hóa các metrics này thành các dashboard trực quan, dễ tùy biến.
Dù vậy, biểu đồ đẹp mới chỉ giải quyết được một nửa vấn đề. Chẳng ai có thể dán mắt vào dashboard 24/7. Việc kết hợp Prometheus với Alertmanager và một bot Telegram tùy chỉnh sẽ chuyển tiếp ngay các thông báo quan trọng—chẳng hạn như dung lượng đĩa chạm ngưỡng 85% hay một node bị mất kết nối—trực tiếp đến điện thoại của bạn hoàn toàn miễn phí.
Cài đặt
Cài đặt các agent giám sát trực tiếp trên hệ điều hành host thường mang lại nhiều phiền toái khi nâng cấp phiên bản Linux. Việc chạy toàn bộ hệ thống bằng Docker Compose giúp cấu hình được cô lập, dễ tái lập và sao lưu nhanh chóng.
Thiết lập cấu trúc thư mục
Tạo một thư mục riêng trên máy chủ host để lưu trữ các file cấu hình và mount persistent volume:
mkdir -p ~/homelab-monitoring/{prometheus,alertmanager,grafana/provisioning}
cd ~/homelab-monitoring
Cấu hình Docker Compose
Lưu nội dung sau vào file docker-compose.yml. Hãy đặc biệt lưu ý đến Node Exporter: dịch vụ này sử dụng network_mode: host, đọc trực tiếp các đường dẫn hệ thống của máy chủ host và bỏ qua lớp ảo hóa của container để thu thập số liệu chuẩn xác như trên bare-metal:
version: '3.8'

networks:
  monitoring:
    driver: bridge

services:
  node-exporter:
    image: prom/node-exporter:v1.8.2
    container_name: node-exporter
    restart: unless-stopped
    volumes:
      - /proc:/host/proc:ro
      - /sys:/host/sys:ro
      - /:/rootfs:ro
    command:
      - '--path.procfs=/host/proc'
      - '--path.rootfs=/rootfs'
      - '--path.sysfs=/host/sys'
      - '--collector.filesystem.mount-points-exclude=^/(sys|proc|dev|host|etc)($$|/)'
    network_mode: host

  prometheus:
    image: prom/prometheus:v2.54.1
    container_name: prometheus
    restart: unless-stopped
    volumes:
      - ./prometheus/prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - ./prometheus/alert_rules.yml:/etc/prometheus/alert_rules.yml:ro
      - prometheus_data:/prometheus
    command:
      - '--config.file=/etc/prometheus/prometheus.yml'
      - '--storage.tsdb.path=/prometheus'
      - '--web.console.libraries=/usr/share/prometheus/console_libraries'
      - '--web.console.templates=/usr/share/prometheus/consoles'
      - '--storage.tsdb.retention.time=30d'
    networks:
      - monitoring
    ports:
      - '9090:9090'

  alertmanager:
    image: prom/alertmanager:v0.27.0
    container_name: alertmanager
    restart: unless-stopped
    volumes:
      - ./alertmanager/alertmanager.yml:/etc/alertmanager/alertmanager.yml:ro
    command:
      - '--config.file=/etc/alertmanager/alertmanager.yml'
    networks:
      - monitoring
    ports:
      - '9093:9093'

  grafana:
    image: grafana/grafana:11.2.0
    container_name: grafana
    restart: unless-stopped
    environment:
      - GF_SECURITY_ADMIN_USER=admin
      - GF_SECURITY_ADMIN_PASSWORD=ChangeMeDevOps123!
      - GF_USERS_ALLOW_SIGN_UP=false
    volumes:
      - grafana_data:/var/lib/grafana
    networks:
      - monitoring
    ports:
      - '3000:3000'

volumes:
  prometheus_data:
  grafana_data:
Cấu hình
Bây giờ hãy liên kết các thành phần lại với nhau: mục tiêu thu thập dữ liệu (scrape targets), ngưỡng kích hoạt và phương thức gửi cảnh báo.
1. Cấu hình Scrape cho Prometheus
Tạo file prometheus/prometheus.yml. Vì Node Exporter sử dụng mạng host trên cổng 9100, bạn có thể kết nối tới nó qua địa chỉ IP LAN của máy host (ví dụ: 192.168.1.50:9100) hoặc IP bridge gateway của Docker (thường là 172.17.0.1:9100):
global:
  scrape_interval: 15s
  evaluation_interval: 15s

rule_files:
  - 'alert_rules.yml'

alerting:
  alertmanagers:
    - static_configs:
        - targets:
            - 'alertmanager:9093'

scrape_configs:
  - job_name: 'prometheus'
    static_configs:
      - targets: ['localhost:9090']

  - job_name: 'homelab-node'
    static_configs:
      - targets: ['172.17.0.1:9100']
2. Định nghĩa các quy tắc cảnh báo (Alert Rules)
Tạo file prometheus/alert_rules.yml. Một lỗi thường gặp với Node Exporter liên quan đến nhãn mountpoint của hệ thống file: việc truyền tham số --path.rootfs=/rootfs sẽ lược bỏ tiền tố này bên trong collector, nghĩa là phân vùng root của máy host sẽ hiển thị là mountpoint="/" chứ không phải /rootfs.
Dưới đây là các quy tắc cảnh báo đã được kiểm thử dành cho sự cố mất kết nối host, CPU tăng đột biến, cạn kiệt RAM và quá tải dung lượng đĩa:
groups:
  - name: HostAlerts
    rules:
      - alert: HostDown
        expr: up{job="homelab-node"} == 0
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: "Máy chủ không thể truy cập"
          description: "Target Node Exporter {{ $labels.instance }} đã ngừng phản hồi hơn 1 phút."

      - alert: HighCpuLoad
        expr: 100 - (avg by(instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100) > 85
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "Mức sử dụng CPU cao"
          description: "Mức sử dụng CPU trên {{ $labels.instance }} đã vượt quá 85% trong 5 phút."

      - alert: DiskRunningLow
        expr: (node_filesystem_avail_bytes{mountpoint="/",fstype!~"tmpfs|overlay"} * 100) / node_filesystem_size_bytes{mountpoint="/",fstype!~"tmpfs|overlay"} < 15
        for: 2m
        labels:
          severity: critical
        annotations:
          summary: "Dung lượng đĩa phân vùng root sắp hết"
          description: "Dung lượng đĩa khả dụng trên phân vùng root của {{ $labels.instance }} dưới 15%."

      - alert: HighMemoryUsage
        expr: (1 - (node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes)) * 100 > 90
        for: 3m
        labels:
          severity: warning
        annotations:
          summary: "Bộ nhớ RAM gần cạn kiệt"
          description: "Mức sử dụng RAM của máy host đã vượt ngưỡng 90% trong 3 phút."
3. Thiết lập Telegram Bot & Alertmanager
Việc tạo thông tin xác thực chỉ mất chưa đầy hai phút:
- Mở Telegram, tìm kiếm @BotFather, gửi lệnh
/newbotvà lưu lại token HTTP API được cung cấp. - Gửi một tin nhắn trực tiếp cho bot mới tạo, hoặc thêm bot vào kênh nhận cảnh báo riêng.
- Lấy chat ID bằng cách truy cập
https://api.telegram.org/bot<YOUR_BOT_TOKEN>/getUpdatestrên trình duyệt và sao chép giá trị số tại trườngmessage.chat.id.
Thêm các thông tin xác thực này vào file alertmanager/alertmanager.yml:
global:
  resolve_timeout: 5m

route:
  group_by: ['alertname', 'instance']
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 3h
  receiver: 'telegram-alerts'

receivers:
  - name: 'telegram-alerts'
    telegram_configs:
      - bot_token: '123456789:ABCdefGhIJKlmNoPQRsTUVwxyZ'
        chat_id: -1001234567890
        parse_mode: 'HTML'
        send_resolved: true
        message: >-
          {{ if eq .Status "firing" }}🔥 <b>CẢNH BÁO KÍCH HOẠT</b>{{ else }}✅ <b>ĐÃ KHẮC PHỤC</b>{{ end }}

          <b>Cảnh báo:</b> {{ .CommonAnnotations.summary }}
          <b>Mức độ:</b> {{ .CommonLabels.severity }}
          <b>Chi tiết:</b> {{ .CommonAnnotations.description }}
Kiểm tra & Giám sát
Khởi chạy toàn bộ stack:
docker compose up -dXác nhận tất cả các container đang hoạt động bình thường:
docker compose psKiểm tra việc thu thập Metric
Mở http://<your-server-ip>:9090 và điều hướng tới Status > Targets. Cả hai endpoint prometheus và homelab-node đều phải hiển thị huy hiệu UP màu xanh lá. Tiếp theo, mở tab Alerts để đảm bảo cả bốn cảnh báo máy chủ đều đang ở trạng thái không hoạt động (inactive).
Import Dashboard Node Exporter Full
- Truy cập
http://<your-server-ip>:3000và đăng nhập với tài khoảnadmincùng mật khẩu đã khai báo trong file compose. - Vào Connections > Data Sources, chọn Add data source, chọn Prometheus, và đặt URL là
http://prometheus:9090. Nhấn Save & Test. - Vào Dashboards > New > Import. Nhập ID dashboard là
1860(dashboard “Node Exporter Full” được cộng đồng duy trì), chọn nguồn dữ liệu Prometheus của bạn, rồi nhấn Import.
Grafana sẽ hiển thị ngay lập tức tải từng nhân CPU, IOPS của từng ổ đĩa, thông lượng giao diện mạng và dung lượng bộ nhớ đệm (buffer).
Kiểm thử quy trình cảnh báo qua Telegram
Đừng bao giờ mặc định hệ thống cảnh báo hoạt động trơn tru cho đến khi bạn thấy nó được kích hoạt trong điều kiện tải cao. Bạn có thể kiểm thử chuỗi thông báo một cách an toàn bằng một container tạo tải nhẹ mà không gây ảnh hưởng đến các dịch vụ đang chạy:
# Tạo tải trên 4 worker CPU trong 6 phút để kích hoạt cảnh báo HighCpuLoad
docker run --rm -it progrium/stress --cpu 4 --timeout 360s
Theo dõi tại http://<your-server-ip>:9093. Cảnh báo HighCpuLoad sẽ chuyển từ trạng thái Pending sang Firing sau năm phút, và bot của bạn sẽ gửi tin nhắn đến Telegram. Sau khi container tạo tải kết thúc, Alertmanager sẽ tự động gửi thông báo RESOLVED màu xanh lá, xác nhận mọi thông số đã quay trở về mức bình thường.