課題の背景:深夜2時のペーパーパニック
ある日曜日の午前2時15分、自宅ラック内のサーバー用電源ユニットのフィルターコンデンサが甲高い音を立てて破裂しました。マシンは即座に停止。ディストリビューターの受付締め切りである午前8時前にRMA(修理・交換依頼)のチケットを切るため、どうしても請求書とシリアルナンバーの控えが必要になりました。しかし、埃をかぶった衣装ケースや靴箱をひっくり返し、電気料金の請求書や古い賃貸契約書の山を40分間捜索したものの、結局その用紙は見つかりませんでした。
紙の原本に依存することは、運用上の重大なリスクです。感熱紙のレシートは半年も経てば白くかすれてしまいます。重要な保証書はデスクの引き出しの奥で行方不明になりがちです。請求書をスキャンしてネットワーク共有フォルダに保存したとしても、生のPDFファイルは中身が不透明なバイナリデータの塊にすぎません。OCR(光学文字認識)がなければ、本文を検索することも、ベンダー名で整理することも、日付で絞り込むことも不可能です。
さらにベトナム語の書類は事態をより複雑にします。多くのオープンソースOCRツールはデフォルトで英語辞書(eng.traineddata)を使用します。そのため、Hóa đơn giá trị gia tăng(付加価値税インボイス)や Hợp đồng lao động(労働契約書)といったアクセント記号を含むテキストを読み込ませると、声調記号が文字化けしたASCII文字列になってしまいます。検索インデックスに「tiền điện」が「ti?n di?n」として記録されてしまえば、検索しても一切ヒットしません。
基本概念:Paperless-ngxのアーキテクチャ
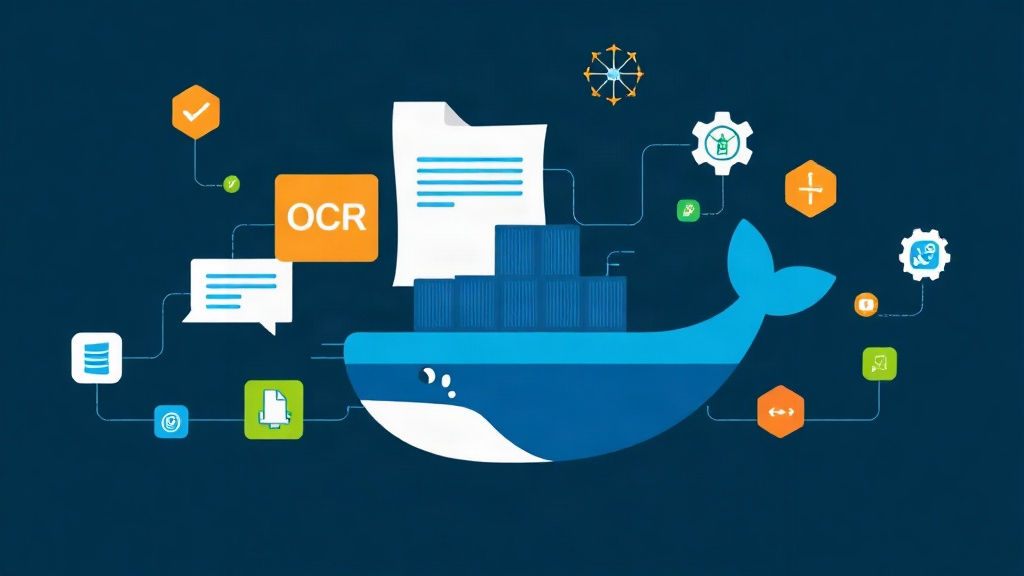
Paperless-ngxはモノリシックな設計を避け、取り込み、パース、インデックス作成、ウェブ配信の各処理を軽量な個別コンテナに分離しています。
- Webserver & API (Django): ダッシュボードUIを提供し、REST APIの呼び出しを処理し、ユーザー権限を適用し、書類のタグ、カスタムフィールド、差出人を管理します。
- Task Queue & Ingestion Workers (Redis): 取り込み用フォルダ内の新規ファイルを監視します。スキャンしたファイルを投入すると、ワーカーがRedisからジョブを取り出し、埋め込み画像を抽出した上で、ウェブ画面をブロックすることなく非同期でOCR処理を実行します。
- OCR Engine (Tesseract 5): ラスタライズされたページのピクセルから直接、検索可能なテキストレイヤーを生成します。
vie.traineddataとeng.traineddataを併用することで、Tesseractは複雑なベトナム語の声調記号や合成母音(ư, ơ, ê, đ など)を高精度に認識します。 - Database & Search Index (PostgreSQL & Whoosh): PostgreSQLは書類のメタデータ、リレーションシップ、監査ログを保存します。Whooshは転置テキストインデックスを管理し、数千ページに及ぶドキュメントに対しても1秒未満でのキーワード検索を実現します。
- Document Conversion (Gotenberg & Apache Tika): オプションの補助サービスとして、Officeファイル(
.docx、.xlsx)をTesseractに渡す前に、標準化された長期保存用PDF/Aフォーマットへと変換します。
実践手順:ベトナム語OCR対応Paperless-ngxのデプロイ
Docker Composeを利用してスタックを実行することで、言語バイナリを分離し、ホストのファイルシステムをクリーンに保ちます。ここでは、ベトナム語と英語の書類を1回のパスでインデックス化できるように多言語OCRを設定します。
ステップ1:ディレクトリ構造の作成と権限設定
Paperless-ngxは、取り込みファイル、生成されたサムネイル、PostgreSQLデータベース用に専用のローカルストレージを必要とします。300 DPIのアーカイブページあたり、およそ1.5 MB〜3 MBの容量を目安に見積もってください。
mkdir -p ~/homelab/paperless/{consume,data,media,export,pgdata,redisdata}
cd ~/homelab/paperless

# 現在のユーザーのUIDとGIDを確認(通常は1000)
id

# コンテナ実行ユーザーに読み取りおよび書き込み権限を付与
sudo chown -R 1000:1000 ~/homelab/paperless
sudo chmod -R 755 ~/homelab/paperless
ステップ2:docker-compose.ymlの作成
以下の設定を ~/homelab/paperless/docker-compose.yml として保存します。起動前にプレースホルダーのデータベースパスワードとシークレットキーを任意の値に変更してください。
services:
  broker:
    image: docker.io/library/redis:7-alpine
    container_name: paperless-redis
    restart: unless-stopped
    volumes:
      - ./redisdata:/data

  db:
    image: docker.io/library/postgres:16-alpine
    container_name: paperless-postgres
    restart: unless-stopped
    environment:
      POSTGRES_DB: paperless
      POSTGRES_USER: paperless_admin
      POSTGRES_PASSWORD: ReplaceWithAStrongSecretDbPassword
    volumes:
      - ./pgdata:/var/lib/postgresql/data

  webserver:
    image: ghcr.io/paperless-ngx/paperless-ngx:latest
    container_name: paperless-web
    restart: unless-stopped
    depends_on:
      - db
      - broker
    ports:
      - "8000:8000"
    environment:
      PAPERLESS_REDIS: redis://broker:6379
      PAPERLESS_DBENGINE: postgresql
      PAPERLESS_DBHOST: db
      PAPERLESS_DBNAME: paperless
      PAPERLESS_DBUSER: paperless_admin
      PAPERLESS_DBPASS: ReplaceWithAStrongSecretDbPassword
      USERMAP_UID: 1000
      USERMAP_GID: 1000
      PAPERLESS_URL: http://192.168.1.100:8000
      PAPERLESS_SECRET_KEY: ChangeThisToRandomHexCharsForSecurity32BitMin
      PAPERLESS_TIME_ZONE: Asia/Ho_Chi_Minh
      # 英語フォールバック付きでベトナム語OCRを設定
      PAPERLESS_OCR_LANGUAGE: vie
      PAPERLESS_OCR_LANGUAGES: "vie eng"
      PAPERLESS_OCR_MODE: skip_archive
      PAPERLESS_TASK_WORKERS: 2
    volumes:
      - ./data:/usr/src/paperless/data
      - ./media:/usr/src/paperless/media
      - ./export:/usr/src/paperless/export
      - ./consume:/usr/src/paperless/consume
ステップ3:初期起動と管理者アカウントの設定
スタックをバックグラウンド(デタッチモード)で起動します。初回起動時、コンテナは上流リポジトリから自動的に vie.traineddata 言語パック(約15 MB)を取得します。
docker compose up -d

# 起動ログとデータベースマイグレーションの進捗を確認
docker compose logs -f webserver
ログに Listening at: http://0.0.0.0:8000 と表示されたら、メインの管理者アカウントを作成します。
docker compose exec -it webserver python3 manage.py createsuperuserプロンプトに従ってユーザー名、管理者メールアドレス、安全なパスワードを入力してください。
ステップ4:ベトナム語OCR取り込みのテスト
ブラウザで http://<サーバーのIPアドレス>:8000 にアクセスしてサインインします。サンプルのベトナム語請求書をconsumeボリュームに配置して、取り込み処理をテストします。
# サンプルPDFを取り込み用(consume)フォルダにコピー
cp ~/test_receipt_vietnamese.pdf ~/homelab/paperless/consume/
書類の取り込みと解析を行うワーカープロセスのログを追跡します。
docker compose logs -f webserver | grep -E "(Consuming|Success|OCR)"標準的な2ページのドキュメントであれば、近年のクアッドコアx86 CPUで4〜10秒程度で処理されます。ウェブ管理画面を開いて処理完了したドキュメントを表示し、“Hóa đơn giá trị gia tăng” や “Mã số thuế” などの特定の語句を検索してみてください。PDFビューア上でマッチした単語が的確にハイライト表示されます。
まとめ:堅牢なドキュメント保管庫を維持するために
コンテナのデプロイ自体は簡単ですが、アーカイブを長期にわたって安定稼働させるには、以下の3つの運用ルーチンを確立することが重要です。
- 日次バックアップの自動化: cron経由で
docker compose exec -T webserver document_exporter ../exportを実行します。生成されたエクスポートディレクトリとpgdataを、オフサイトのS3バケットやセカンダリNASなどの暗号化されたリモート環境に同期してください。 - 自動マッチングルールの作成: ベトナムの納税者番号(MST)に基づいた自動タグ付けルールを設定します。既知の10桁の税コードを検出した際に、差出人や書類タイプを自動的に割り当てることができます。
- ハードウェアリソースの管理: 一括取り込み中、Tesseractは手元のCPUコアを容易に使い果たします。Intel N100やRaspberry Pi 5のような省電力ハードウェアでは、サーマルスロットリングやメモリ不足(OOM)によるクラッシュを防ぐため、
PAPERLESS_TASK_WORKERS: 1に設定することをおすすめします。
適切にチューニングされたPaperless-ngxがあれば、乱雑に積まれた紙の山を、構造化された検索自在のナレッジベースへと変貌させることができます。次にマシントラブルが発生したときや確定申告の時期が来ても、書類の捜索にかかる時間は何時間ではなく、わずか数秒で済むはずです。