Đêm Hôm Đó Backup Không Dùng Được
Một đồng nghiệp của tôi từng làm tại một startup fintech. Họ có PostgreSQL backup chạy hàng đêm qua cron — pg_dump, gzip, upload lên S3. Gọn gàng, đơn giản, tự động. Cho đến khi server chính bị crash.
Họ tiến hành restore. File backup vẫn còn đó. Họ chạy lệnh restore. Thất bại. File bị hỏng âm thầm — một lỗi disk I/O xảy ra giữa chừng khi ghi dữ liệu ba tuần trước đã lặng lẽ làm hỏng file, và không ai hay biết vì chưa ai thực sự thử restore nó bao giờ.
Đó không phải là backup. Đó là cảm giác an toàn giả tạo khoác chiếc áo của backup.
Tại Sao Điều Này Xảy Ra Thường Xuyên Hơn Bạn Nghĩ
Hầu hết các team thiết lập backup xong rồi không bao giờ đụng tới nữa. Script backup chạy, file được lưu đâu đó, dashboard monitoring hiển thị màu xanh, và mọi người ngủ ngon. Nhưng có nhiều nguy cơ tiềm ẩn bên dưới:
- Hỏng dữ liệu âm thầm: Lỗi disk, mất kết nối mạng, hoặc sự cố filesystem đều có thể làm hỏng file backup mà không ghi ra bất kỳ lỗi nào trong cron log của bạn.
- Ghi dữ liệu không hoàn chỉnh: Nếu quá trình backup bị kill giữa chừng (OOM killer, timeout, server restart), bạn sẽ có một file bị cắt ngắn nhưng trông bình thường khi nhìn thoáng qua.
- Schema không khớp khi restore: Backup restore thành công — nhưng rồi ứng dụng lỗi vì một bảng hoặc cột không còn khớp với môi trường đích.
- Credential và quyền bị lệch: Restore thành công về mặt kỹ thuật, nhưng user database được restore không có đủ quyền trong môi trường mới.
- Database version không tương thích: pg_dump từ PostgreSQL 14 sẽ không restore được vào PostgreSQL 12 trong một số trường hợp nhất định.
Nguyên nhân gốc rễ luôn giống nhau: backup là thao tác ghi mà không ai đọc lại. Bạn chỉ phát hiện ra chúng bị hỏng khi thực sự cần dùng đến.
Ba Cách Tiếp Cận — và Tại Sao Hai Cách Không Đủ
Cách 1: Kiểm Tra Thủ Công Định Kỳ
Một số team lên lịch “diễn tập restore” hàng quý — họ chọn một bản backup, dựng môi trường test, và thử restore. Cách này tốt hơn không làm gì, nhưng vì là thủ công nên hay bị bỏ qua khi mọi người bận, và định kỳ hàng quý có nghĩa là tới 90 ngày dữ liệu hỏng không bị phát hiện. Nó cũng không bắt được bản backup 3 giờ sáng thứ Ba tuần trước đã lặng lẽ thất bại.
Cách 2: Chỉ Xác Minh Checksum
Tiến bộ hơn một bậc: tạo hash MD5 hoặc SHA256 của file backup ngay sau khi tạo, rồi xác minh hash trước khi restore. Cách này phát hiện hỏng dữ liệu trong quá trình truyền hoặc lưu trữ. Tốt — nhưng không cho bạn biết backup có hợp lệ về mặt logic không. Một file gzip đầy đủ, không bị hỏng của một pg_dump ghi dở dang sẽ qua được kiểm tra checksum và vẫn thất bại khi restore.
Cách 3: Pipeline Tự Động Restore và Xác Minh
Đây là cách thực sự hoạt động. Mỗi bản backup tự động được restore vào môi trường tạm thời, các kiểm tra tính toàn vẹn chạy trên dữ liệu đã restore, và bạn chỉ nhận cảnh báo khi có gì đó thất bại. Còn lại là yên lặng màu xanh. Đây là cách xây dựng nó.
Xây Dựng Pipeline: Từng Bước Một
Bước 1 — Backup Có Cấu Trúc Kèm File Metadata
Làm cho script backup xuất ra một file metadata JSON cùng với file dump. Đây trở thành hợp đồng mà job xác minh đọc sau này:
#!/bin/bash
BACKUP_DIR="/backups/postgres"
TIMESTAMP=$(date +%Y%m%d_%H%M%S)
BACKUP_FILE="$BACKUP_DIR/db_$TIMESTAMP.dump"
META_FILE="$BACKUP_DIR/db_$TIMESTAMP.meta.json"

pg_dump -Fc -h localhost -U postgres mydb > "$BACKUP_FILE"
EXIT_CODE=$?

SHA256=$(sha256sum "$BACKUP_FILE" | awk '{print $1}')
SIZE=$(stat -c%s "$BACKUP_FILE")

cat > "$META_FILE" <<EOF
{
  "timestamp": "$TIMESTAMP",
  "exit_code": $EXIT_CODE,
  "file": "$BACKUP_FILE",
  "sha256": "$SHA256",
  "size_bytes": $SIZE,
  "pg_version": "$(pg_dump --version | grep -oP '\d+\.\d+')",
  "verified": false
}
EOF
Cờ verified bắt đầu là false và chỉ được chuyển thành true sau khi chu kỳ restore-và-kiểm-tra thành công. Nếu nó vẫn là false, bạn biết có gì đó đã xảy ra.
Bước 2 — Restore Cách Ly Trong Docker Container Tạm Thời
Việc restore nên diễn ra trong môi trường cách ly — một container mới hoàn toàn và bị xóa sau đó, không để lại trạng thái nào:
#!/bin/bash
# restore_and_verify.sh
BACKUP_FILE="$1"
CONTAINER="pg-verify-$(date +%s)"

docker run -d \
  --name "$CONTAINER" \
  -e POSTGRES_PASSWORD=verifypass \
  -e POSTGRES_DB=verify_db \
  postgres:16 > /dev/null

sleep 5  # chờ postgres khởi động xong

# Restore backup
docker exec -i "$CONTAINER" \
  pg_restore -U postgres -d verify_db < "$BACKUP_FILE"
RESTORE_EXIT=$?

if [ $RESTORE_EXIT -ne 0 ]; then
  echo "RESTORE THẤT BẠI: $BACKUP_FILE"
  docker rm -f "$CONTAINER"
  /opt/scripts/send_alert.sh "Restore thất bại cho $BACKUP_FILE"
  exit 1
fi

# Chuyển sang bước kiểm tra tính toàn vẹn
python3 /opt/scripts/verify_integrity.py "$CONTAINER" "$BACKUP_FILE"
VERIFY_EXIT=$?

docker rm -f "$CONTAINER"
exit $VERIFY_EXIT
Bước 3 — Kiểm Tra Tính Toàn Vẹn SQL Trên Dữ Liệu Đã Restore
Restore thành công thôi chưa đủ. Chạy các câu query thực tế để xác minh dữ liệu có hợp lý với ứng dụng của bạn không. Điều chỉnh các kiểm tra này theo schema của bạn — mục tiêu là phát hiện hỏng dữ liệu về mặt logic, không chỉ lỗi kỹ thuật:
import subprocess
import json
import sys

def run_check(container, query, description):
    result = subprocess.run(
        ["docker", "exec", container,
         "psql", "-U", "postgres", "-d", "verify_db",
         "-t", "-c", query],
        capture_output=True, text=True
    )
    value = result.stdout.strip()
    print(f"[KIỂM TRA] {description}: {value}")
    return value

container = sys.argv[1]
backup_file = sys.argv[2]
meta_file = backup_file.replace(".dump", ".meta.json")

checks = [
    ("SELECT COUNT(*) FROM users", "số dòng bảng users"),
    ("SELECT COUNT(*) FROM orders WHERE created_at > NOW() - INTERVAL '30 days'", "đơn hàng gần đây"),
    ("SELECT MAX(updated_at) FROM products", "thời gian cập nhật sản phẩm mới nhất"),
]

failed = 0
for query, desc in checks:
    result = run_check(container, query, desc)
    if result in ("", "0", None):
        print(f"[CẢNH BÁO] Kết quả đáng ngờ cho: {desc}")
        failed += 1

with open(meta_file, "r+") as f:
    meta = json.load(f)
    meta["verified"] = (failed == 0)
    meta["check_failures"] = failed
    f.seek(0)
    json.dump(meta, f, indent=2)
    f.truncate()

if failed > 0:
    subprocess.run(["/opt/scripts/send_alert.sh",
                    f"{failed} kiểm tra tính toàn vẹn thất bại cho {backup_file}"])

sys.exit(0 if failed == 0 else 1)
Bảng users có zero dòng là dấu hiệu đáng lo. Cũng vậy với timestamp “sản phẩm cập nhật mới nhất” từ ba năm trước trên một bảng bạn biết thay đổi hàng ngày. Các kiểm tra phải phản ánh thế nào là bình thường đối với database của bạn.
Bước 4 — Kết Nối Tất Cả Bằng Cron
# /etc/cron.d/backup-verify
# Backup lúc 2 giờ sáng, xác minh lúc 3 giờ sáng
0 2 * * * postgres /opt/scripts/backup.sh >> /var/log/backup.log 2>&1
0 3 * * * postgres /opt/scripts/restore_and_verify.sh \
  $(ls -t /backups/postgres/*.dump | head -1) >> /var/log/verify.log 2>&1
Bước 5 — Cảnh Báo Khi Thất Bại, Im Lặng Khi Thành Công
Pipeline nên vô hình khi mọi thứ hoạt động tốt. Một Slack webhook đơn giản xử lý cảnh báo mà không cần thêm hạ tầng phức tạp:
#!/bin/bash
# send_alert.sh
MESSAGE="$1"
WEBHOOK_URL="https://hooks.slack.com/services/YOUR/WEBHOOK"

curl -s -X POST -H 'Content-type: application/json' \
  --data "{\"text\": \":rotating_light: Xác Minh Backup DB THẤT BẠI: $MESSAGE\"}" \
  "$WEBHOOK_URL"
Lưu Ý Thực Tế Về Chuyển Đổi Định Dạng Dữ Liệu
Một điều hay gặp trong quá trình xác minh restore: đôi khi tôi cần kiểm tra hoặc đối chiếu dữ liệu bảng xuất ra ở các định dạng khác nhau — chẳng hạn so sánh số dòng từ file CSV xuất ra với số dòng sau khi restore trước và sau khi migration.
Khi cần nhanh chóng chuyển CSV sang JSON để import dữ liệu hoặc kiểm tra nhanh như vậy, tôi dùng toolcraft.app/vi/tools/data/csv-to-json — chạy hoàn toàn trên trình duyệt, dữ liệu không rời khỏi máy bạn. Điều đó quan trọng khi bạn đang xử lý các file database xuất ra nhạy cảm và không muốn pipe chúng qua một dịch vụ online ngẫu nhiên nào đó.
Pipeline Hoàn Chỉnh Trông Như Thế Nào
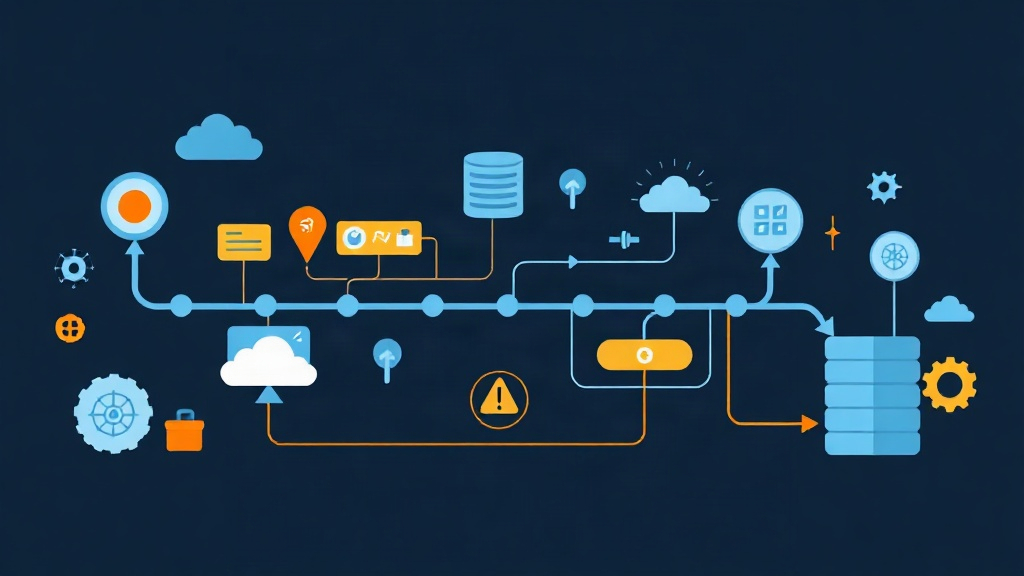
- 2:00 SA — pg_dump chạy; file metadata được tạo kèm SHA256, kích thước và exit code
- 3:00 SA — Script restore lấy file .dump mới nhất, khởi động Docker container, tiến hành restore
- 3:10 SA — Python integrity checker chạy các câu SQL query, cập nhật
verified: true/falsetrong metadata - 3:11 SA — Cảnh báo Slack gửi đi nếu có gì thất bại; nếu không thì hoàn toàn im lặng
- 3:12 SA — Docker container bị xóa, giải phóng dung lượng đĩa
Toàn bộ chu kỳ mất dưới 15 phút cho database 5GB. Các file metadata tích lũy dần như một audit trail — bất kỳ ngày nào bạn cũng có thể nhìn lại và thấy chính xác bản backup nào là bản được xác minh cuối cùng, và khi nào.
Các Kiểm Tra Bổ Sung Nên Thêm Khi Đã Ổn Định Cơ Bản
- Cảnh báo chênh lệch số dòng: So sánh số dòng restore hôm nay với hôm qua. Bảng users giảm 90% chỉ qua một đêm gần như chắc chắn không phải điều bình thường.
- Đo thời gian restore: Theo dõi thời gian restore mất bao lâu. Đột ngột tăng gấp 3 lần có thể báo hiệu backup đang tăng kích thước bất thường, hoặc Docker host thiếu tài nguyên.
- Smoke test ở tầng ứng dụng: Sau khi restore, trỏ endpoint healthcheck của ứng dụng vào database đã restore. Database restore thành công nhưng làm ứng dụng lỗi khi khởi động vẫn là một lần phục hồi thất bại.
- Xác minh từ offsite: Nếu bạn upload backup lên S3, chạy một job riêng download từ S3 và xác minh lại. Cách này phát hiện các lỗi upload âm thầm mà bạn sẽ không bao giờ thấy nếu không làm vậy.
Thay Đổi Tư Duy Mới Thực Sự Quan Trọng
Thay đổi thực sự ở đây không phải về kỹ thuật — mà là coi mọi bản backup là chưa được xác minh cho đến khi chứng minh được ngược lại. Một bản backup chưa được restore là một giả thuyết, không phải lưới an toàn.
Khi pipeline này hoạt động, có điều gì đó thay đổi trong cách team bạn nói về backup. Thay vì “chúng ta có backup”, bạn bắt đầu nói “bản backup được xác minh cuối cùng của chúng ta là 18 giờ trước.” Đó là một cuộc trò chuyện hoàn toàn khác về bản chất — và là mức độ chính xác thực sự quan trọng khi có sự cố xảy ra lúc 2 giờ sáng.