Bối cảnh & Lý do: Những điểm mù trong cơ sở dữ liệu Production
Vận hành PostgreSQL trên môi trường production mà không có hệ thống đo kiểm thời gian thực (telemetry) chẳng khác nào một canh bạc mà sớm muộn gì bạn cũng sẽ thua. Mọi thứ dường như vẫn chạy êm ả cho đến khi một truy vấn JOIN thiếu index khóa chặt bảng đơn hàng, lượng connection chạm trần lúc 9 giờ sáng, hoặc autovacuum bị tụt lại tới 50 GB so với khối lượng ghi. Việc chỉ phụ thuộc vào error log và thỉnh thoảng mở pg_top kiểm tra đồng nghĩa với việc bạn chỉ phát hiện ra sự cố sau khi người dùng đã phàn nàn.
Cơ sở dữ liệu hiếm khi sập mà không có dấu hiệu báo trước. Thay vào đó, hiệu năng sẽ suy giảm dần qua từng ngày: tỷ lệ buffer cache hit giảm từ 99,2% xuống 87%; độ trễ disk I/O wait tăng vọt từ 2 ms lên 45 ms; replication lag kéo dài từ 10 mili-giây lên 8 giây. Một pipeline thu thập metric liên tục sẽ giúp bạn phát hiện sớm những dấu hiệu suy giảm này trước khi chúng bùng phát thành sự cố nghiêm trọng làm gián đoạn toàn bộ hệ thống.
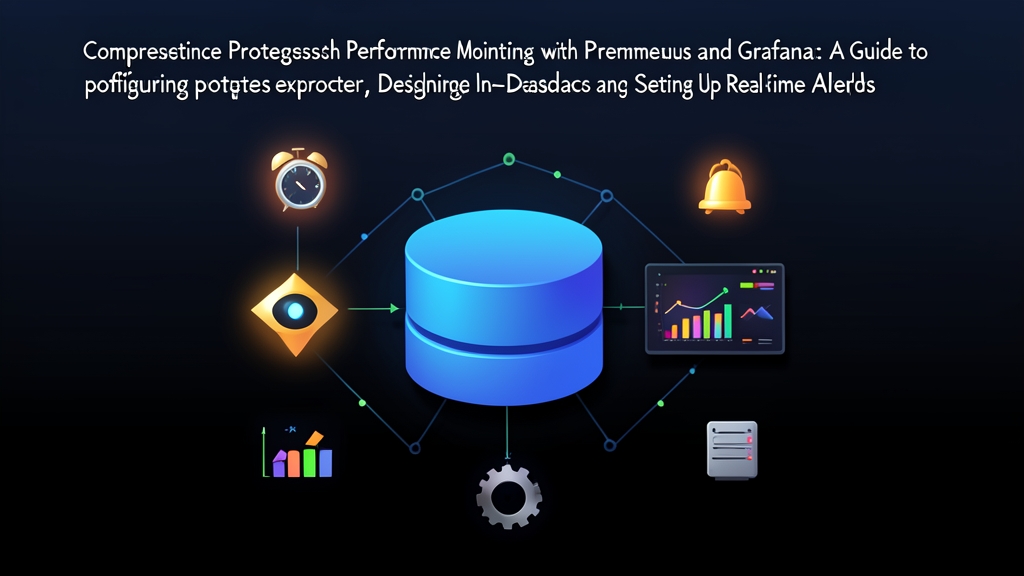
Bộ ba công cụ bổ trợ dưới đây sẽ giúp bạn xây dựng pipeline này một cách gọn gàng:
- postgres_exporter: Kết nối tới PostgreSQL thông qua một user bị giới hạn quyền và chuyển đổi dữ liệu từ các catalog view (như
pg_stat_databasevàpg_stat_activity) thành các định dạng gauge và counter của Prometheus. - Prometheus: Định kỳ scrape endpoint của exporter mỗi 15 giây, đánh chỉ mục các điểm dữ liệu time-series và liên tục đánh giá các ngưỡng cảnh báo.
- Grafana: Trực quan hóa dữ liệu thu thập được trên các dashboard thời gian thực và bắn webhook cảnh báo đến Slack, PagerDuty hoặc Discord khi các truy vấn vi phạm cam kết SLA.
Trước khi đưa lên production, quá trình benchmark và kiểm thử trên staging luôn đòi hỏi schema và dữ liệu thực tế. Nếu cần xử lý nhanh các file seed data, công cụ toolcraft.app/vi/tools/data/csv-to-json sẽ giúp chuyển đổi các file CSV trích xuất thô thành payload JSON chuẩn ngay trên trình duyệt mà không cần tải dữ liệu nhạy cảm lên máy chủ từ xa. Sau khi nạp dữ liệu vào bảng test và chạy thử tải giả lập, hệ thống giám sát sẽ chỉ ra chính xác mức độ tiêu hao CPU, lock và I/O của từng mẫu truy vấn.
Cài đặt: Triển khai Stack giám sát
Docker Compose giúp toàn bộ telemetry stack được cô lập và dễ dàng tái lập trên các máy chủ staging lẫn production. Nếu độ trễ mạng giữa các container là vấn đề đáng ngại, bạn có thể chạy postgres_exporter dưới dạng một systemd unit độc lập ngay trên chính node cơ sở dữ liệu.
1. Tạo User chuyên dụng trong cơ sở dữ liệu
Tuyệt đối không dùng thông tin đăng nhập của superuser postgres cho các dịch vụ bên thứ ba. Từ PostgreSQL 10 trở lên đã cung cấp sẵn role pg_monitor, cho phép truy cập đầy đủ các bảng chẩn đoán nội bộ mà không cần cấp quyền đọc dữ liệu trong các bảng:
-- Chạy với quyền superuser postgres
CREATE USER postgres_exporter WITH PASSWORD 'YourSecureExporterPasswordHere!';
GRANT pg_monitor TO postgres_exporter;
GRANT CONNECT ON DATABASE production_db TO postgres_exporter;
Role này có thể đọc các chỉ số máy chủ, trạng thái truy vấn đang chạy và các bảng lock một cách an toàn mà không thể đọc dữ liệu dòng nhạy cảm hay thay đổi các cấu hình runtime.
2. Triển khai bằng Docker Compose
Tạo một thư mục có tên pg-monitoring và lưu file docker-compose.yml sau:
version: '3.8'

services:
  postgres_exporter:
    image: prometheuscommunity/postgres-exporter:v0.15.0
    container_name: postgres_exporter
    restart: unless-stopped
    environment:
      DATA_SOURCE_NAME: "postgresql://postgres_exporter:[email protected]:5432/production_db?sslmode=disable"
    ports:
      - "9187:9187"

  prometheus:
    image: prom/prometheus:v2.52.0
    container_name: prometheus
    restart: unless-stopped
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - ./alert_rules.yml:/etc/prometheus/alert_rules.yml:ro
      - prometheus_data:/prometheus
    command:
      - '--config.file=/etc/prometheus/prometheus.yml'
      - '--storage.tsdb.path=/prometheus'
      - '--storage.tsdb.retention.time=15d'
    ports:
      - "9090:9090"

  grafana:
    image: grafana/grafana:11.0.0
    container_name: grafana
    restart: unless-stopped
    ports:
      - "3000:3000"
    volumes:
      - grafana_data:/var/lib/grafana
    environment:
      - GF_SECURITY_ADMIN_USER=admin
      - GF_SECURITY_ADMIN_PASSWORD=AdminSecurePassword123

volumes:
  prometheus_data:
  grafana_data:
Cấu hình: Kết nối Metric, Dashboard và Cảnh báo
1. Kích hoạt pg_stat_statements trong PostgreSQL
Để theo dõi thời gian thực thi truy vấn cùng với mức tiêu thụ tài nguyên phần cứng, hãy bật pg_stat_statements trong file postgresql.conf:
# postgresql.conf
shared_preload_libraries = 'pg_stat_statements'
pg_stat_statements.track = all
pg_stat_statements.max = 10000
track_io_timing = on
track_activity_query_size = 2048
Khởi động lại PostgreSQL để nạp shared library. Sau đó, đăng ký extension này bên trong database mục tiêu:
CREATE EXTENSION IF NOT EXISTS pg_stat_statements;2. Cấu hình Scrape và Quy tắc cảnh báo cho Prometheus
Lưu file cấu hình mẫu prometheus.yml sau vào thư mục triển khai:
global:
  scrape_interval: 15s
  evaluation_interval: 15s

rule_files:
  - "alert_rules.yml"

scrape_configs:
  - job_name: 'postgres'
    static_configs:
      - targets: ['postgres_exporter:9187']
        labels:
          environment: 'production'
          cluster: 'main-postgres'
Tiếp theo, định nghĩa các điều kiện cảnh báo thực tế trong alert_rules.yml. Hãy cân chỉnh các ngưỡng cẩn thận để tránh tình trạng quá tải cảnh báo (alert fatigue):
groups:
  - name: postgresql_alerts
    rules:
      - alert: PostgresDown
        expr: pg_up == 0
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: "Instance PostgreSQL không thể kết nối"
          description: "postgres_exporter không thể kết nối tới instance PostgreSQL mục tiêu trong hơn 1 phút."

      - alert: HighConnectionUsage
        expr: (sum(pg_stat_database_numbackends) by (instance) / pg_settings_max_connections) * 100 > 85
        for: 3m
        labels:
          severity: warning
        annotations:
          summary: "Connection pool vượt quá 85% dung lượng"
          description: "Số lượng backend connection đang hoạt động vượt quá 85% giới hạn max_connections."

      - alert: LowCacheHitRatio
        expr: (rate(pg_stat_database_blks_hit[5m]) / (rate(pg_stat_database_blks_hit[5m]) + rate(pg_stat_database_blks_read[5m]))) * 100 < 90
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "Tỷ lệ buffer cache hit giảm xuống dưới 90%"
          description: "Tỷ lệ buffer cache hit duy trì dưới 90% trong 10 phút. Hãy kiểm tra xem có thiếu index không."

      - alert: DeadlockDetected
        expr: increase(pg_stat_database_deadlocks[5m]) > 0
        labels:
          severity: critical
        annotations:
          summary: "Phát hiện deadlock giữa các transaction"
          description: "PostgreSQL ghi nhận một hoặc nhiều deadlock trong vòng 5 phút qua."
3. Khởi chạy các dịch vụ và Cấu hình Grafana
Khởi chạy các container ở chế độ chạy nền (detached mode):
docker compose up -dMở http://<your-server-ip>:3000 trên trình duyệt và đăng nhập bằng tài khoản admin. Kết nối Grafana với Prometheus qua các bước nhanh sau:
- Truy cập Connections > Data Sources > Add data source và chọn Prometheus.
- Nhập
http://prometheus:9090vào trường Prometheus server URL. - Nhấn Save & Test. Đảm bảo thấy thông báo màu xanh báo kết nối thành công.
- Điều hướng tới Dashboards > New > Import, nhập dashboard ID từ cộng đồng là
9628(PostgreSQL Database), rồi chọn data source Prometheus vừa tạo.
Xác thực & Giám sát: Kiểm tra Telemetry và Đọc các chỉ số quan trọng
1. Kiểm tra Endpoint của Exporter
Kiểm tra xem postgres_exporter đã thu thập các metric nội bộ đúng cách hay chưa bằng cách gọi trực tiếp vào HTTP endpoint thô của nó:
curl -s http://localhost:9187/metrics | grep -E "^(pg_up|pg_stat_database_xact_commit)"Kết quả đầu ra dự kiến sẽ tương tự như sau:
pg_stat_database_xact_commit{datname="production_db"} 482910
pg_up 1
Giá trị pg_up 1 xác nhận thông tin xác thực cơ sở dữ liệu hợp lệ và kết nối mạng hoạt động bình thường.
2. Các chỉ số quan trọng cần theo dõi trên Dashboard
Hãy luôn chú ý đến 5 chỉ số sau trong quá trình rà soát vận hành hằng ngày:
- Tỷ lệ Commit so với Rollback (Commit vs. Rollback Ratio): Một ứng dụng ổn định thường duy trì tỷ lệ commit trên 99,5%. Việc số lượng rollback tăng đột biến là dấu hiệu của exception ở tầng ứng dụng, vi phạm ràng buộc khóa ngoại (foreign key) hoặc lỗi serialization.
- Số connection hoạt động theo trạng thái (Active Connections by State): Phân biệt rõ giữa các trạng thái đang thực thi (active execution), client socket rảnh rỗi (idle client sockets) và
idle in transaction. Một connection bị kẹt ở trạng tháiidle in transactionquá 30 giây sẽ giữ các chuỗi lock và ngăn cản autovacuum dọn dẹp bảng. - Tỷ lệ Buffer Cache Hit (Buffer Cache Hit Ratio): Các tải làm việc dạng OLTP nên duy trì tỷ lệ này ổn định trên 98%. Nếu tỷ lệ tụt xuống dưới 90%, cần kiểm tra xem
shared_bufferscó bị thiếu RAM hay không hoặc các truy vấn sequential scan thiếu index đang làm tràn bộ nhớ đệm cache block. - Replication Lag theo Byte: Đối với các replica vật lý dạng streaming, hãy theo dõi
pg_stat_replication. Độ trễ lag vượt quá 50 MB cảnh báo nghẽn cổ chai ghi đĩa ở replica hoặc các batch transaction quá lớn ở primary node. - Tuổi Transaction ID Wraparound (Transaction ID Wraparound Age): Theo dõi sát chỉ số
pg_database_datfrozenxid_age. Nếu số lượng giao dịch vượt quá 200 triệu mà autovacuum freeze chưa chạy, cơ sở dữ liệu có nguy cơ bị buộc dừng hoạt động khi chạm ngưỡng 2 tỷ transaction.
3. Kiểm thử Kích hoạt Cảnh báo
Đừng bao giờ mặc định rằng hệ thống cảnh báo sẽ tự động hoạt động trơn tru cho đến khi bạn tự mình kích hoạt thử. Hãy tạo tải đồng thời giả lập trên môi trường staging bằng pgbench với một tài khoản ứng dụng (không dùng tài khoản monitoring chỉ đọc):
# Khởi tạo hệ số tỷ lệ 20 (~2.000.000 dòng) bằng user có quyền ghi của ứng dụng
pgbench -i -s 20 -U app_user -h localhost -d production_db

# Mở 80 kết nối đồng thời trên 4 worker thread trong vòng 2 phút
pgbench -c 80 -j 4 -T 120 -U app_user -h localhost production_db
Truy cập http://localhost:9090/alerts. Cảnh báo HighConnectionUsage sẽ chuyển từ trạng thái Pending sang Firing ngay khi lượng kết nối duy trì vượt ngưỡng quá 3 phút. Khi cảnh báo được kích hoạt, bạn có thể yên tâm rằng hệ thống thông báo đã vận hành chính xác.